复用、解码流程与渲染的设计 Ⅰ
好久没有写技术博客了,前几期都是在抒发个人情绪,这期我们来转移方向。
嗯,这次是记录一次我的一个播放器类的项目
https://github.com/RinzeMoon/RinzePlayer-master
我的项目链接在这里,项目的解码播放等部分复用了AZPlayer项目,续用了GPL3.0 协议的同时代码全部开源。
不如说是对AZPlayer的再讲解,闲话少叙。接下来就开始吧。
Utils
template <typename E>
constexpr auto to_index(E e) -> std::underlying_type_t<E> {
    return static_cast<std::underlying_type_t<E>>(e);
}
这是一个Enum转Index的模板函数。
也就是说将任意枚举类型的值,安全地转换为其对应的底层整数值。
auto to_index(E e) -> std::underlying_type_t<E>
使用 C++11 的 trailing return type 语法,返回类型为 std::underlying_type_t<E>。
std::underlying_type_t<E> 是 C++14 引入的辅助类型,等价于 typename std::underlying_type<E>::type,它提取枚举 E 的底层类型(例如 int、unsigned char 等)。如果枚举未显式指定底层类型,则取编译器默认的类型(通常是 int,但标准只规定“足够容纳所有枚举值”)。
static_cast<...>(e)
将枚举值 e 显式转换为其底层整型。对于作用域枚举(enum class),这种转换不能隐式发生,必须用 static_cast;对于无作用域枚举(enum),虽然可以隐式转换,但显式 static_cast 可以避免意外的类型提升或警告。统一使用 static_cast 使得函数适用于任意枚举。
SPSCQueue 生产者单消费者Buffer
Private
private:
    size_t nextIndex(size_t index) const {
        return (index + 1) % m_capacity;
    }

    const size_t m_capacity; // 环形缓冲区的总容量(包括浪费的一个位置)
    std::vector<T> m_buffer; // 数据缓冲区

    alignas(hardware_destructive_interference_size) std::atomic<size_t> m_head{0}; // 读索引(消费者使用)
    alignas(hardware_destructive_interference_size) std::atomic<size_t> m_tail{0}; // 写索引(生产者使用)
    std::atomic<int> m_serial{0};
其中 alignas hardware_destructive_interference_size 为 m_head/m_tail 指定一个对齐要求,按照 硬件破坏性干扰大小 对齐到内存地址上,目的是解决伪共享问题。[1]
强制叉开 m_head m_tail 距离64个字节,从而解决伪共享问题,是一种空间换性能的模式。
剩余的就是 size_t nextIndex(size_t index) const 以及一些原子变量,都是具体情况下RingBuffer的实现了。
public
bool push(const T &value) {
        // 生产者本地快照
        size_t current_tail = m_tail.load(std::memory_order_relaxed);
        size_t next_tail = nextIndex(current_tail);

        // 检查队列是否已满
        if (next_tail == m_head.load(std::memory_order_acquire)) {
            return false; // 队列满,推送失败
        }

        // 将数据存入当前tail指向的位置
        m_buffer[current_tail] = value;

        // 发布tail的更新,确保前面的数据存储对消费者可见
        m_tail.store(next_tail, std::memory_order_release);
        return true;
    }

    bool pop(T &value) {
        // 消费者本地快照
        size_t current_head = m_head.load(std::memory_order_relaxed);

        // 检查队列是否为空
        if (current_head == m_tail.load(std::memory_order_acquire)) {
            return false; // 队列空,弹出失败
        }

        // 从当前head指向的位置取出数据
        value = m_buffer[current_head];

        // 发布head的更新,告知生产者新的头部位置
        m_head.store(nextIndex(current_head), std::memory_order_release);
        return true;
    }
-
内存序:
pushm_tail.load(relaxed)– 读自己的写指针,无同步需求。m_head.load(acquire)– 读消费者的读指针,与消费者的m_head.store(release)配对,确保看到最新的可写槽位。m_tail.store(..., release)– 发布新的尾部位置,与消费者的m_tail.load(acquire)配对,确保写入的数据对消费者可见。
Popm_head.load(relaxed)– 读自己的读指针,无同步需求。m_tail.load(acquire)– 读生产者的写指针,与生产者的m_tail.store(release)配对,确保看到生产者写入的数据。m_head.store(..., release)– 发布新的头部位置,与生产者的m_head.load(acquire)配对,通知生产者该槽位已释放。
if (current_head == m_tail.load(std::memory_order_acquire)) 中 std::memory_order_acquire
-
有一个小问题,为什么要用acquire序呢?
-
为了建立 happens‑before 关系,保证数据可见性
生产者执行(
push):m_buffer[current_tail] = value; // (A) 写入数据 m_tail.store(next_tail, release); // (B) 发布新 tail消费者执行(
pop):if (current_head == m_tail.load(acquire)) // (C) 读取 tail return false; value = m_buffer[current_head]; // (D) 读取数据- 当消费者在
(C)读到m_tail的值不等于current_head时,说明这个m_tail的值是生产者通过(B)写入的。 - 由于
(B)使用release,(C)使用acquire,这两者之间建立了 synchronizes-with 关系。 这保证了:(A)(写 buffer)在(B)之前发生,而(B)同步到(C),所以(A)happens‑before(D)。 - 因此消费者在
(D)中读取m_buffer[current_head]时,一定能看到生产者写入的正确数据(不会读到旧数据或未初始化的内容)。
如果没有
acquire,即使(C)读到了新tail,编译器或 CPU 可能将(D)重排到(C)之前,导致读取发生在(A)之前 → 数据竞争。 - 当消费者在
AVPktQueue
privateprivate: mutable std::mutex m_mutex; std::deque<AVPktItem> m_queue; const size_t m_maxBytes; // 总字节上限 size_t m_currentBytes; // 当前总字节数 std::atomic<int> m_serial{0};由此可见,这是一个带了互斥锁的队列,底层是
std::deque<T>。它的
push与pop操作和前面SPSC是同理的,但它是互斥锁,名为AVPktQueue,因此重点放在AVPkt上,是针对AVPktItem的buffer。 -
-
struct AVPktItem {
    AVPacket *pkt = nullptr;
    int serial = 0;
};
Demux
我们正式转到解复用部分,有一个ChapterInfo 的结构体定义。
struct ChapterInfo {
    double pts;        // 秒
    std::string title; // 描述
};
它把内容分成 Chapter 并且为其中赋予了描述。
weakFrmQueue
从这里插一下,因为里面有很多弱引用的队列,它的实现很简单,只是一层包装。
using weakFrmQueue = std::weak_ptr<SPSCQueue<AVFrmItem>>;
Demux类
private
- FFmpeg 核心上下文 与 资源标识
AVFormatContext *m_formatCtx = nullptr;	//它是 FFmpeg 解封装层的句柄

std::string m_URL;   // 媒体 URL (本地文件路径/网络流地址)
bool m_isMainDemux = false;  // 标记该解复用器是否为主播放链路的解复用器
- 流索引的管理
std::vector<int> m_videoIdx, m_audioIdx, m_subtitleIdx;     // 所有可用的流索引列表
std::atomic<int> m_usedVIdx{-1}, m_usedAIdx{-1}, m_usedSIdx{-1}; // 当前选中的流索引
前三个 vector 保存从 AVFormatContext 中扫描出的所有视频/音频/字幕流的 stream_index。
后三个 atomic<int> 表示当前激活的流,-1 表示未选中。使用 atomic 保证在读取线程与用户操作(如切流)间的可见性。
weakPktQueue m_audioPktBuf;
weakPktQueue m_videoPktBuf;
weakPktQueue m_subtitlePktBuf;
weakFrmQueue m_audioFrmBuf;
weakFrmQueue m_videoFrmBuf;
weakFrmQueue m_subtitleFrmBuf;  //由此可见,各种各样的buffer
把Demux对应的 package Buffer 和 Frame Buffer 都用std::weak_ptr封装到 Demux类里了,这种设计使得解复用器不直接拥有队列,避免了循环引用,同时模块间解耦。
Demux::Init & uninit
Init的函数标识是这样的
bool Demux::init(const std::string URL, bool isMainDemux)
我们分布拆解这个函数
- 重复初始化保护
if (m_initialized) {
    uninit();
}
如果类内的 m_initialized 为true的话,程序需要进行反初始化来避免内存泄漏,解复用器回到初始状态,保证了解复用环节的初步安全性。
- 打开媒体文件
int ret = avformat_open_input(&m_formatCtx, URL.c_str(), nullptr, &opts);
av_dict_free(&opts);
if (ret != 0) {
    av_strerror(ret, errBuf, 512);
    qDebug() << errBuf;
    return false;
}
这真属于老生常谈的部分了,做播放器调用FFmpeg根本离不开这个环节。
- 设置最大帧间隔
double maxFrameDuration = (m_formatCtx->iformat->flags & AVFMT_TS_DISCONT) ? 10.0 : 3600.0;
GlobalClock::instance().setMaxFrameDuration(maxFrameDuration);
根据输入格式是否支持不连续时间戳(AVFMT_TS_DISCONT)来设置全局时钟的最大帧间隔。不连续时间戳常见于某些网络流,此时最大间隔设为 10 秒,否则设为 3600 秒(1 小时)。这对于后续音视频同步非常重要,避免因时间戳跳跃导致播放异常。
- 探测流信息
ret = avformat_find_stream_info(m_formatCtx, nullptr);
if (ret < 0) {
    av_strerror(ret, errBuf, 512);
    qDebug() << errBuf;
    avformat_close_input(&m_formatCtx);
    return false;
}
avformat_find_stream_info 会读取数据包,解析每个流的编码参数、码率、时长等信息。在成功调用才能获取可用的流信息。如果失败,关闭上下文并结束init。
- 各类型流的索引
for (unsigned int i = 0; i < m_formatCtx->nb_streams; ++i) {
    AVMediaType sType = m_formatCtx->streams[i]->codecpar->codec_type;
    if (sType == AVMEDIA_TYPE_VIDEO)
        m_videoIdx.push_back(i);
    else if (sType == AVMEDIA_TYPE_AUDIO)
        m_audioIdx.push_back(i);
    else if (sType == AVMEDIA_TYPE_SUBTITLE)
        m_subtitleIdx.push_back(i);
}
根据前面获得的**m_formatCtx** 格式上下文来进行遍历,为private 的字段填充信息,可以作为后续进行流切换的基础。
Uninit
bool Demux::uninit() {
    stop();
    if (m_formatCtx) {
        avformat_close_input(&m_formatCtx);
    }

    m_URL.clear();

    m_videoIdx.clear();
    m_audioIdx.clear();
    m_subtitleIdx.clear();

    for (auto &v : m_stringInfo) {
        v.clear();
    }

    m_chaptersInfo.clear();

    m_usedVIdx.store(-1, std::memory_order_relaxed);
    m_usedAIdx.store(-1, std::memory_order_relaxed);
    m_usedSIdx.store(-1, std::memory_order_relaxed);

    m_initialized = false;

    m_audioPktBuf.reset();
    m_videoPktBuf.reset();
    m_subtitlePktBuf.reset();
    m_audioFrmBuf.reset();
    m_videoFrmBuf.reset();
    m_subtitleFrmBuf.reset();

    return true;
}
这部分无疑就是清理资源,和析构函数有着差不多地位的作用,这里就不太过多叙述了。
Demux::start
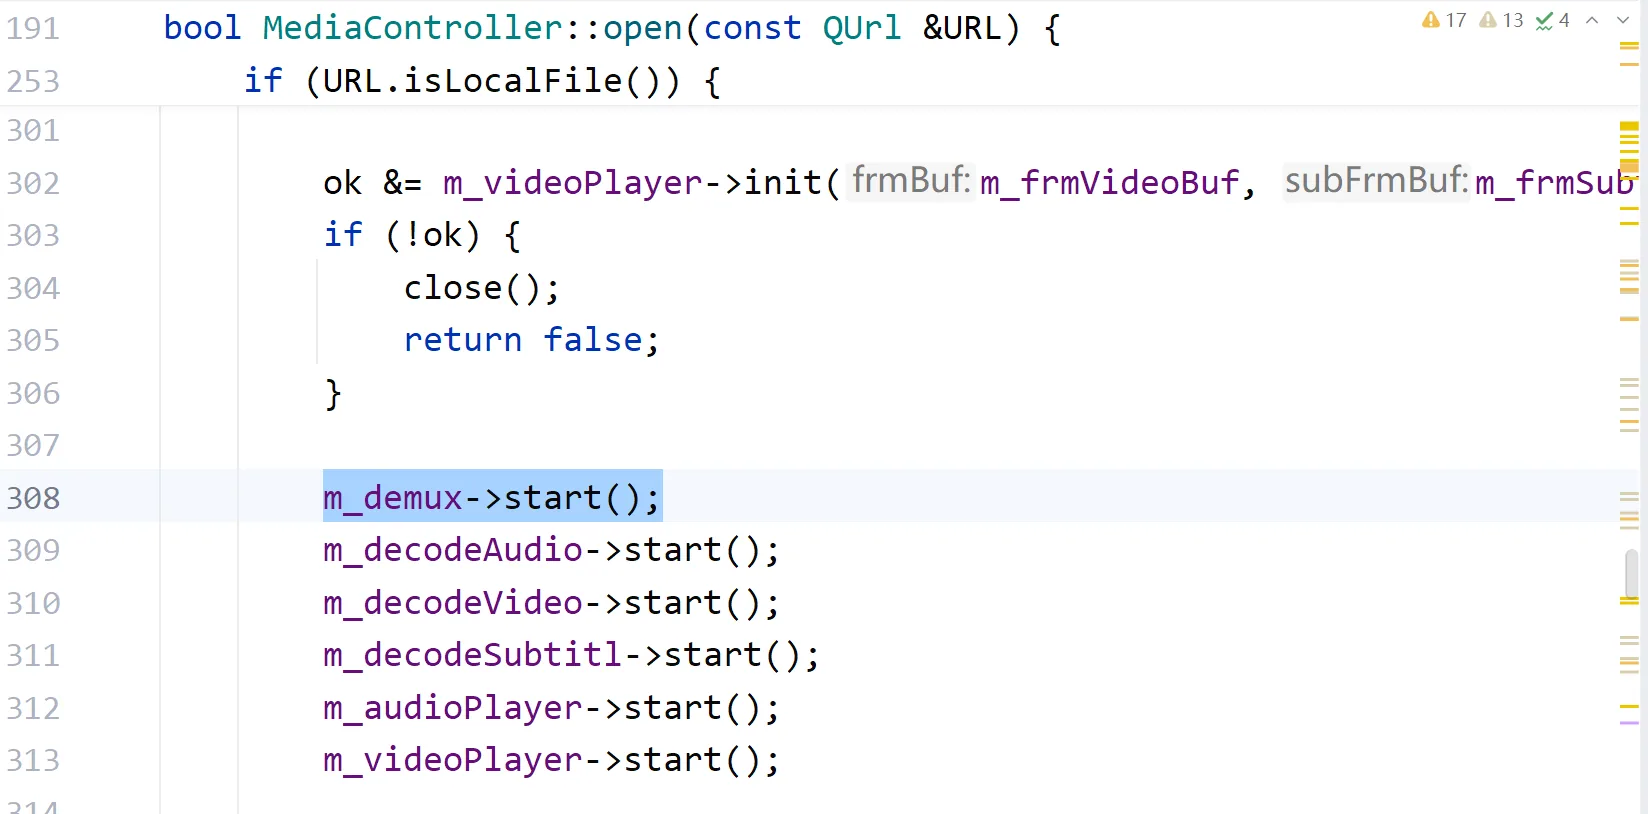
要清楚的是demux实例在MediaController里所占有的,从openURL的功能被调用。 然后接下来进入start函数。
void Demux::start() {
    if (m_thread.joinable()) {
        return; // 已经在运行了
    }
    m_stop.store(false, std::memory_order_relaxed);
    m_thread = std::thread([this]() {
        demuxLoop();
    });
}
DemuxLoop
我们自然而然的进入解复用Loop的环节。
Demux::demuxLoop 是被拖入线程的一个函数,我们分为四部分来进行探索。
- Seek处理
if (m_needSeek.load(std::memory_order_acquire)) {
    seekAllPktQueue();
    int streamIdx = m_isMainDemux ? -1 : (m_usedVIdx != -1) ? m_usedVIdx.load()
                                     : (m_usedAIdx != -1)   ? m_usedAIdx.load()
                                                            : m_usedSIdx.load();
    double time_base = streamIdx == -1 ? 1.0 / AV_TIME_BASE : av_q2d(m_formatCtx->streams[streamIdx]->time_base);
    double target = m_seekTs / time_base;
    int64_t seekMin = m_seekRel > 0.0 ? static_cast<int64_t>(target - m_seekRel * AV_TIME_BASE + 2) : INT64_MIN;
    int64_t seekMax = m_seekRel < 0.0 ? static_cast<int64_t>(target - m_seekRel * AV_TIME_BASE - 2) : INT64_MAX;
    int ret = avformat_seek_file(m_formatCtx, streamIdx, seekMin, target, seekMax,
                                 m_usedVIdx == -1 ? AVSEEK_FLAG_ANY : 0);
    emitRealSeekTs = m_isMainDemux;
    m_needSeek.store(false, std::memory_order_release);
}
- 这部分很长
- 首先要处理
VideoAudio或者是字幕流的队列,把它们清除后才可以继续seek。 - 再就是获取 流id,从m_usedVIdx 系列原子变量 load 获得。
- 从格式上下文
m_formatCtx里获取 timeBase,前提是在av_q2d函数里计算获得[2]
- 首先要处理
如果没有参考流,就用默认AV_TIME_BASE 的倒数,其中 AV_TIME_BASE 定义为
/**
 * Internal time base represented as integer
 */
/* From avutil.h */
#define AV_TIME_BASE            1000000
- 接下来就用
m_seekTs/time_base的计算值来规定 target。目的是把绝对时间转化为对应 timebase 下的规范时间戳。 - seekMin & seekMax
- 用于为
avformat_seek_file提供一个时间范围,允许它在这个范围内寻找合适的关键帧,而不是必须精确到target点。 - 核心逻辑是基于
m_seekRel(由seekBySec(double ts, double rel)传入的rel参数)来决定的。
- 用于为
在 demuxLoop 的 seek 处理中,m_seekRel 的符号决定了 seek 的搜索区间:
-
向后定位(
m_seekRel > 0): 我们希望 seek 到 ≥ 目标时间点的位置,所以:seekMin = target - m_seekRel * AV_TIME_BASE + 2 seekMax = INT64_MAX限制最小时间戳,让 FFmpeg 在
[seekMin, 无穷大)区间内寻找,确保不会返回target之前的帧。+2是一个微小的容错偏移,避免边界上的四舍五入问题。 -
向前定位(
m_seekRel < 0): 希望 seek 到 ≤ 目标时间点的位置,所以:seekMin = INT64_MIN seekMax = target - m_seekRel * AV_TIME_BASE - 2限制最大时间戳,区间为
(负无穷, seekMax],保证不跳到target之后。-2同理是边界容错。 -
精确定位(
m_seekRel == 0): 两个三元表达式都不成立,seekMin = INT64_MIN,seekMax = INT64_MAX,等于不限范围,完全由target和 flag 决定。
最后调用avformat_seek_file(m_formatCtx, streamIdx, seekMin, target, seekMax,m_usedVIdx == -1 ? AVSEEK_FLAG_ANY : 0); 来具体执行seek。
最后 m_needSeek.store(false, std::memory_order_release); 存储false值,结束seek。
		pkt = av_packet_alloc();
        int ret = av_read_frame(m_formatCtx, pkt);
        if (ret < 0) {
            if (ret == AVERROR_EOF && !m_isEOF) { // EOF
                Q_ASSERT(pkt->data == NULL && pkt->size == 0);
                pushVideoPkt(pkt);
                pkt = av_packet_alloc();
                pushSubtitlePkt(pkt);
                pkt = av_packet_alloc();
                pushAudioPkt(pkt);
                pkt = nullptr;
                qDebug() << "解复用EOF";
                m_isEOF = true;
            } else if (ret != AVERROR_EOF) { // error
                qDebug() << "解复用出错";
                goto end;
            }
            std::this_thread::sleep_for(std::chrono::milliseconds(10));
            continue;
        } else {
            m_isEOF = false;
        }

        if (emitRealSeekTs) {
            Q_ASSERT(m_isMainDemux);
            double seekedPts = pkt->pts * av_q2d(m_formatCtx->streams[pkt->stream_index]->time_base);
            // 提前设置一下时钟,能比较好的避免出现视频pts先更新且落后与音频,导致视频疯狂更新,然后音频再更新,导致视频领先与音频,最后导致视频变卡一会儿
            GlobalClock::instance().setAudioClk(seekedPts);
            GlobalClock::instance().setVideoClk(seekedPts);
            emit seeked(seekedPts);
            emitRealSeekTs = false;
        }

        // ret == 0
        if (pkt->stream_index == m_usedAIdx.load(std::memory_order_acquire)) {
            pushAudioPkt(pkt);
        } else if (pkt->stream_index == m_usedVIdx.load(std::memory_order_acquire)) {
            pushVideoPkt(pkt);
        } else if (pkt->stream_index == m_usedSIdx.load(std::memory_order_acquire)) {
            pushSubtitlePkt(pkt);
        } else {
            av_packet_free(&pkt);
        }
        pkt = nullptr;
    }

end:
    if (pkt) {
        av_packet_free(&pkt);
    }
}
- 异常处理
- EOF:首次读到文件末尾时,为每个流推一个空包(flush 包),通知解码器输出剩余帧。
- 其他错误:直接跳到结尾释放包,结束线程。
- 无论哪种失败,都睡眠 10ms 后继续(或退出)。
- Seek后的同步
if (emitRealSeekTs) {
    double seekedPts = pkt->pts * av_q2d(...);
    GlobalClock::instance().setAudioClk(seekedPts);
    GlobalClock::instance().setVideoClk(seekedPts);
    emit seeked(seekedPts);
    emitRealSeekTs = false;
}
直接同步更新全局时钟为seekedPts,避免视频pts先更新且落后与音频,导致视频疯狂更新,然后音频再更新,导致视频领先与音频,最后导致视频变卡。
流的切换
bool Demux::switchStream(MediaType type, int streamIdx, weakPktQueue wpq, weakFrmQueue wfq)
-
根据媒体类型获取对应数据结构
switch (type) { case MediaType::Video: idxVec = &m_videoIdx; usedIdx = &m_usedVIdx; ... break; case MediaType::Audio: idxVec = &m_audioIdx; usedIdx = &m_usedAIdx; ... break; case MediaType::Subtitle: ... break; }- 用
type决定操作哪一套成员:可用流列表 (m_videoIdx等)、当前激活索引 (m_usedVIdx等)、弱引用包队列和帧队列。 - 特殊处理:如果是视频流,还会从该流的
avg_frame_rate和codecpar提取帧率、编码名称、封装格式名称,存入全局PlaybackStats供 UI 显示。
- 用
-
然后就是关闭当前流 并检查索引合法性与更新队列和索引
if (usedIdx->load() != -1) {
    closeStream(type);
}
Q_ASSERT(streamIdx < idxVec->size());
{
    std::lock_guard<std::mutex> mtx(m_mutex);
    *pktBuf = wpq;
    *frmBuf = wfq;
    usedIdx->store((*idxVec)[streamIdx], std::memory_order_release);
}
streamIdx是可用流列表的下标,而非流的原始stream_index。真正的原始索引从(*idxVec)[streamIdx]取出。- 加锁更新:保证包队列、帧队列的绑定和当前使用索引的修改是原子性的(对
demuxLoop可见)。
同步播放位置并处理线程
if (m_stop.load()) {
    double pts = GlobalClock::instance().getMainPts();
    if (!std::isnan(pts)) {
        int64_t target = pts / av_q2d(getStream(type)->time_base);
        int streamIndex = (*idxVec)[streamIdx];
        int flags = (m_usedVIdx == -1) ? AVSEEK_FLAG_ANY : 0;
        ok = avformat_seek_file(m_formatCtx, streamIndex, INT64_MIN, target, INT64_MAX, flags);
    }
    start();
}
- 获取当前主时钟(主 Demux 的播放位置)作为 seek 目标。
- 将秒数换算为新流的
time_base单位。 - 若当前没有激活视频流,使用
AVSEEK_FLAG_ANY允许 seek 到任意帧(包括非关键帧),否则用默认模式。 - 执行 seek 后调用
start(),重新开启解复用线程。
Final
差不多就讲到这里了,一些更细节的小操作,比如 fillStreamInfo start/stop、pushPkt 等等可以在下一期进行补全,这里已经来到4000字了,再写下去不是很合适。